Agenten sind stark, wenn sich eindeutig prüfen lässt, ob sie ihr Ziel erreicht haben: eine Testsuite, die grün werden soll, ein Parser, der schneller werden muss. Dann probieren sie, messen, verbessern und hören auf, sobald das Ziel erreicht ist. Bei der Frage „Ist dieser Code gut lesbar?“ gibt es nichts, woran sie messen könnten. Kein Test schlägt fehl, weil eine Methode zu lang ist oder ein Kommentar die halbe Entstehungsgeschichte erzählt.
Meine Beobachtung: LLMs schreiben nicht unbedingt guten Code, aber im Beurteilen von Code sind sie gar nicht schlecht. Das lässt sich nutzen: Ein Agent bewertet, ein anderer verbessert, Runde für Runde, bis die Bewertung stimmt. So kommen Agenten auch dort schrittweise voran, wo kein Test „besser“ oder „fertig“ meldet.
Manche Qualität testet man, manche beurteilt man
Hill Climbing ist das, was Agenten am besten können: einen kleinen Schritt machen, prüfen, ob es besser geworden ist, den nächsten Schritt machen. Das funktioniert hervorragend, solange sich das Ergebnis eindeutig prüfen lässt. Man gibt dem Agenten einen Haufen Unit-Tests, und er schreibt den Algorithmus, bis alle grün sind. Man gibt ihm Beispiele einer Sprache, und er schreibt den Parser dazu. Braucht das Parsen zehn Sekunden pro Beispiel, iteriert er, bis es eine Zehntelsekunde ist.
Viele Qualitäten, die in der Softwareentwicklung zählen, haben diese Eigenschaft nicht. Sieht die Oberfläche gut aus? Ist der Code lesbar, ist er einfach? Dafür wird kein Test rot oder grün. Das ist auch einer der Gründe, warum KI-generierter Code im ersten Anlauf oft nicht besonders schön aussieht: Dem Agenten fehlt die Rückmeldung, ob er auf dem richtigen Weg ist.
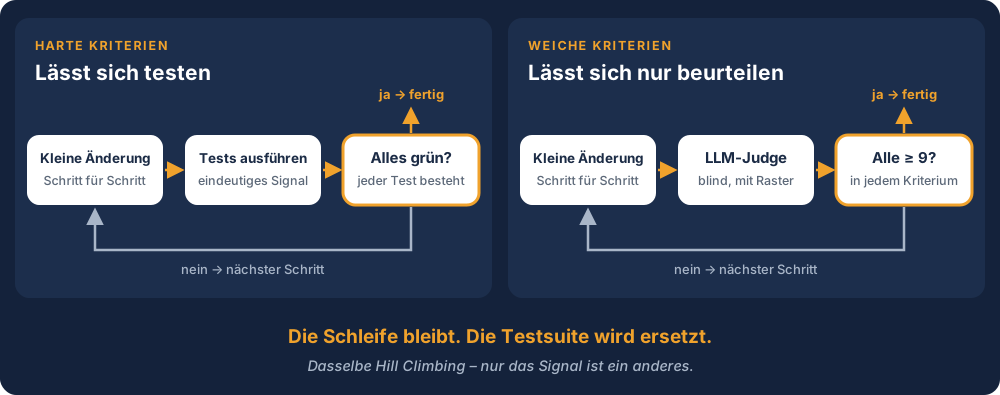
Die Idee: Man behält die Schleife und ersetzt die Testsuite. Ein zweiter Agent, der Judge, bewertet das Ergebnis anhand eines Bewertungsrasters, das ich festlege, und der arbeitende Agent iteriert, bis jede Kategorie einen Schwellwert erreicht. Damit übernimmt der Judge die Rolle der Tests: Das Raster macht aus „gut“ eine Zahl, die sich Schritt für Schritt verbessern lässt.
Dieselbe Schleife, zwei Arten von Signal. Bei harten Kriterien entscheidet die Testsuite, ob alles grün ist. Bei weichen Kriterien übernimmt ein blinder LLM-Judge mit Bewertungsraster diese Rolle, und die Frage lautet: Liegen alle Kategorien bei mindestens 9?
Die Schleife am Beispiel Refactoring
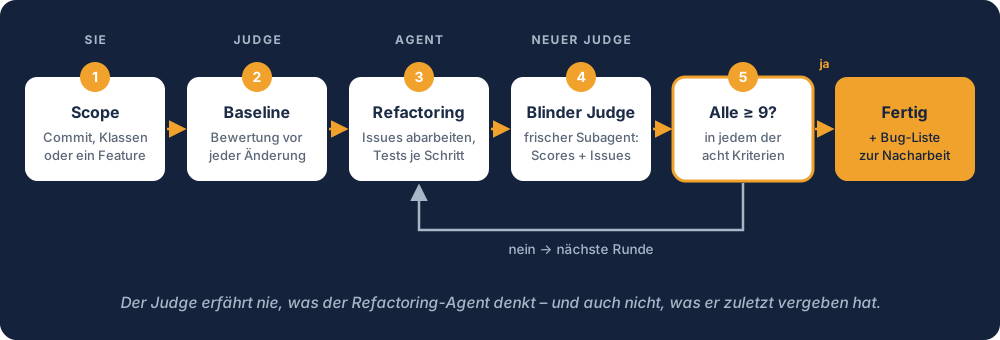
Umgesetzt habe ich das als Refactoring-Skill. Am Anfang steht der Scope: ein Commit, ein paar Klassen, ein Package oder ein beschriebenes Feature, dessen Code sich der Agent selbst zusammensucht. In Runde 0 bewertet ein Judge den unveränderten Code, das ist die Baseline. Danach arbeitet der Refactoring-Agent die Hinweise ab, die am schlechtesten bewerteten Kategorien zuerst, und lässt nach jeder Änderung die Tests laufen. Anschließend bewertet ein frischer Judge den neuen Stand. Das wiederholt sich, bis jede Kategorie mindestens bei 9 liegt. Eine einstellbare Obergrenze, standardmäßig sechs Runden, verhindert Endlosläufe, und auf einem Plateau bricht die Schleife ebenfalls ab.
Was „gut“ heißt, legt das Bewertungsraster fest. Für Code verwende ich acht klassische Kriterien, die man auch in einem guten menschlichen Review anlegen würde, jeweils bewertet mit 1 bis 10 Punkten:
Kriterium
Leitfrage
Lesbarkeit
Ist der Code beim ersten Lesen klar?
Einfachheit
Steckt nicht mehr drin als nötig?
Modularität
Gibt es klare Teile mit klaren Grenzen?
Duplikation
Gibt es jede Logik nur einmal?
Änderbarkeit
Lässt sich der Code sicher und leicht ändern?
Testbarkeit
Lässt er sich gut testen?
Idiomatische Konsistenz
Entspricht er den Gepflogenheiten der Sprache und den Konventionen der Codebasis?
Dokumentation
Erklärt sie das Warum, statt die Entstehungsgeschichte zu erzählen?
Entscheidend ist, dass die Punkte nicht aus dem Bauch kommen. Der Judge stuft jedes gefundene Problem als major ein (ein Reviewer würde blockieren), als minor (lohnt sich zu beheben) oder als nit (kosmetisch). Die Punktzahl folgt daraus:
Punkte
Bedeutung
10
keine Probleme
9
nur Nits
8
ein oder zwei Minor-Probleme
7
mehrere Minor-Probleme
5–6
ein Major-Problem, ein Reviewer würde blockieren
1–4
mehrere Major-Probleme, Änderungen am Code sind riskant
Jedes Problem zählt nur in einer Kategorie, damit derselbe Mangel nicht doppelt bestraft wird. Ich behaupte nicht, dass diese Skala ideal ist. Sie lässt sich sicher noch verbessern, und unter 6 rutscht in der Praxis vermutlich selten etwas.
Ein berechtigter Einwand: Der Code wird so zweimal analysiert, einmal vom Judge und noch einmal vom Refactoring-Agenten. Deshalb liefert der Judge mehr als Zahlen. Pro Kategorie kommt eine einzeilige Begründung, dazu konkrete Probleme mit Schweregrad, Datei, Zeile und einem Vorschlag zur Verbesserung. Vermutete Bugs landen in einer eigenen Liste mit Findings, die in keine Punktzahl einfließt. Mit einer bloßen 7 bei der Dokumentation müsste der Refactoring-Agent erst alles selbst noch einmal durchleuchten.
Der Ablauf des Refactoring-Skills: Scope festlegen, Baseline bewerten, refaktorisieren und von einem frischen, blinden Judge neu bewerten lassen. Liegt eine Kategorie unter 9, folgt die nächste Runde. Am Ende stehen besserer Code und eine Liste der gefundenen Bugs.
Wer den Code schreibt, bewertet ihn nicht
Ein Agent mag seinen eigenen Code. Sagt man ihm einfach „refaktorisiere das“, kommt deshalb wenig heraus: Er findet den Code, den er gerade geschrieben hat, ziemlich gut. Also lasse ich einen anderen urteilen, und der muss wirklich unabhängig sein.
Jede Runde bekommt deshalb einen neuen Subagenten, denn ein früherer Judge würde sich an seinen alten Punkten orientieren. Gestartet wird der Judge mit einer festen, vorab geschriebenen Prompt-Vorlage und nicht mit einem Prompt, den der Refactoring-Agent selbst formuliert, sonst wandert Wissen aus dessen Kontext mit hinüber. Das Ziel erfährt der Judge nicht. Ein Satz wie „wir wollen überall eine 9“ wäre eine Einladung, einfach überall eine 9 zu vergeben. Er kennt weder die bisherigen Punkte noch die Änderungen, und einen Diff bekommt er auch nicht. Er bewertet den Code so, wie er jetzt ist.
Leitplanken, damit die Schleife konvergiert
Erst die Tests. Bevor irgendetwas angefasst wird, prüft der Agent, ob eine Änderung überhaupt sicher ist. Ist Verhalten nicht durch Tests abgedeckt, schreibt er zuerst Charakterisierungstests, die den aktuellen Stand festhalten. Ist die Baseline rot, wird nicht refaktorisiert. Assertions bestehender Tests bleiben unangetastet: Braucht ein Test plötzlich einen anderen erwarteten Wert, hat sich Verhalten geändert, und genau das darf ein Refactoring nicht.
Bugs aufschreiben, nicht beheben. Refactoring erhält Verhalten, vermutete Bugs kommen auf eine eigene Liste. Das hat direkte Folgen für die Konvergenz, denn ein Bug kann verhindern, dass sich Code vereinheitlichen lässt: Genau an seiner Stelle wird ein Fall anders behandelt. Sitzt ein Mensch mit in der Schleife, fragt der Agent nach. Läuft alles unbeaufsichtigt, legt er ein Ticket an, schreibt den Fund in eine Datei oder behebt ihn, wenn das so vereinbart ist. In einem Lauf hat der Agent das selbst erkannt und sinngemäß gemeldet: Wir sind noch nicht überall bei 9, aber wir konvergieren nicht, weil Bug X noch im Code steckt, und den soll ich ja nicht beheben.
Eine Untergrenze für Kleinkram. Ein Reviewer mit frischem Blick findet gerne etwas. Ohne Untergrenze findet der Judge immer etwas, und die Schleife hört nie auf. Deshalb steckt die Untergrenze in Skala und Regeln: Reine Nits ergeben immer noch eine 9 und stehen dem Schwellwert nicht im Weg. Der Judge listet nur die Probleme auf, die eine Punktzahl unter 10 rechtfertigen, und fehlende Konfigurierbarkeit oder Abstraktionen zählen nur, wenn eine aktuelle oder absehbare Anforderung sie braucht. „Nichts Relevantes gefunden“ ist damit ein legitimes Ergebnis.
9, nicht 10. Die Bewertungen schwanken. Ein LLM liefert keinen exakt reproduzierbaren Wert, zwischen zwei Runden liegt schnell ein Punkt Unterschied. Wer überall eine 10 verlangt, wartet auf einen Glückstreffer. Die Latte darf nicht zu hoch liegen, muss aber hoch genug sein, dass die Qualität tatsächlich steigt.
Enger Scope. Ein Commit, ein paar Klassen, ein Feature, nie das ganze Projekt. Das wäre ungefähr so wie „implementiere mir alles in einem Rutsch“: Man kann kaum noch beurteilen, ob hinterher alles funktioniert wie vorher, und die Änderung sprengt jedes Review. Der Skill ist für lokale Refactorings gedacht, eine globale Umstrukturierung der Architektur bräuchte einen anderen.
Kommentare sagen, warum. Warum es den Code gibt und welchen Einschränkungen er unterliegt, nicht, was er tut, und nicht, wie wir dahin gekommen sind. LLMs neigen dazu, ihre eigene Denkgeschichte in Kommentare zu schreiben: Prozesserzählungen, Tasknummern, Formulierungen wie „vorher“, „jetzt“ oder „nicht mehr“, Verweise auf Pläne und Reviews. Das gehört in die Commit-Message oder nirgendwohin.
Was die Schleife aus ungeprüftem KI-Code gemacht hat
Getestet habe ich den Skill an einem einzelnen Package eines Repositorys, dessen Code vollständig von KI erzeugt und nie von einem Menschen reviewt wurde. Keine der folgenden Änderungen habe ich ausdrücklich verlangt, das Bewertungsraster hat gereicht.
Aus einer langen Testklasse hat der Agent eine Gruppe von Tests herausgelöst, die von einer URL abhingen und mit den übrigen nichts zu tun hatten. Übrig blieben zwei in sich homogene Testklassen. Einen weiteren Test hat er vereinfacht.
In der Hauptklasse sind die Kommentare deutlich kürzer geworden, die Prozesserzählung ist verschwunden, und was übrig bleibt, erklärt das Warum. Ein bis dahin unkommentierter Statuscode hat dafür eine Erklärung bekommen. Hartcodierte Werte wurden zu benannten Konstanten, eine statische Hilfsmethode zur Auflösung der Basis-URL ist in eine eigene Klasse gewandert. Besonders aufgefallen sind mir die vielen try/catch-Blöcke, die jeweils eine einzige Operation umschlossen und dieselbe Exception fingen. Daraus wurde eine Hilfsmethode mit einem funktionalen Interface, das try/catch steht nur noch an einer Stelle. Das ist ein Stück weit Stilfrage, aber ich finde den Code so besser. Dazu kamen ein paar überflüssige Properties, deren Entfernung nichts kaputt machte. Die Klasse ist von knapp 400 auf gut 300 Zeilen geschrumpft.
Der ursprüngliche Code war nicht schlimm, grobe Schnitzer gab es keine. Das Ergebnis ist aber schlicht besser, und auf den ersten Blick wüsste ich nicht, wie ich es noch wesentlich verbessern sollte. Solche Extraktionen habe ich nicht gesehen, wenn ich einem LLM nur gesagt habe: „Refaktorisiere das, mach es besser.“ Das kann allerdings auch an besseren Modellen liegen.
Bemerkenswert fand ich die Konsistenz. Ich habe den Skill in etwa drei Durchgängen verfeinert und dabei jeweils die Ergebnisse zurückgespielt. Jedes Mal kamen dieselben Änderungen heraus: Testklasse extrahiert, Konstanten herausgezogen, Lambdas eingeführt. Das wirkte fast deterministisch, eine Beobachtung, keine Garantie. Auch die Konvergenz wurde besser. Anfangs brauchte ein Lauf teilweise fünf Runden, mit dem verfeinerten Skill passierte das meiste in der ersten: Kommentare, Struktur, Tests. In Runde 2 bewertete der Judge die Dokumentation bereits als so, wie sie sein sollte, und der Agent zog die Konstanten heraus, danach nur noch Kleinigkeiten, bis der Judge zufrieden war. Ein Lauf dauerte einige Minuten.
Ein Nebeneffekt hat mich überrascht. Wer refaktorisiert, muss den Code verstehen, und dabei sind dem Agenten mehrere Bugs aufgefallen, teilweise nicht unkritische: So wurden etwa Credentials ins Log geschrieben. Gesucht hatte ich danach gar nicht. Auf die Frage, ob er zwei davon gleich mitbeheben solle, war meine Antwort: nein, aufschreiben, nur refaktorisieren.
Warum sich die zusätzlichen Token lohnen
Natürlich kostet das Token. Besserer Code kostet aber auch Menschen Zeit, und die Erfahrung sagt, dass sich die Investition lohnt, bei handgeschriebener Software genauso wie hier. Drei Gründe gehen dabei über hübscheren Code hinaus.
Erstens bleibt weniger Rauschen im Kontext. Prozessgeschichten und Tasknummern in Kommentaren blähen ihn auf und führen den nächsten Agenten in die Irre, genau wie einen Menschen. Selbst wer den Code nur noch im Review oder gar nicht mehr liest: Der nächste Agent liest ihn. Zweitens werden weniger Stellen übersehen. Steckt dieselbe Logik in fünf Kopien, landet ein Fix in zweien und verfehlt drei. Das passiert in echten Projekten, und manchmal fallen die drei offenen Stellen erst im Review auf. Eine einzige Hilfsmethode lässt sich nicht halb reparieren. Drittens bekommt der nächste Agent besseren Input: Einfacher, idiomatischer, sauber aufgeteilter Code ist leichter zu lesen und lässt sich leichter korrekt ändern.
Wo die Schleife in den Workflow passt
Wie man die Schleife in den Alltag einbaut, ist noch offen. Sie kann auf Zuruf laufen, vor jedem Commit, so wie ich auch von Hand vor dem Commit noch einmal aufräume, oder als Schritt in einem Review-Skill für Pull Requests, immer mit kleinem Scope. Ist ein Mensch dabei, behebt man gefundene Bugs zuerst und refaktorisiert danach, in getrennten Commits. Unbeaufsichtigt öffnet der Agent ein Ticket und refaktorisiert trotzdem. Ein kleines Refactoring kann in die eigentliche Änderung einfließen, ein großer Qualitätssprung verdient einen eigenen Commit, damit die fachliche Änderung reviewbar bleibt.
Erfahrene Reviewer werden die Pfadfinderregel ins Spiel bringen: vor und nach einer Änderung bewerten und nur dort refaktorisieren, wo die Qualität gesunken ist. Steht die Codebasis schon überall bei 9, tut die Schleife schlicht nichts. Dazu kommt, dass eine Änderung einen minimalen Diff will, ein Refactoring dagegen den besten Code. Wahrscheinlich braucht es dafür zwei Review-Skills mit unterschiedlichen Prioritäten.
Und neue Modelle, die denselben Code womöglich strenger sehen? Die Zahlen sind willkürlich. 9 von 10 bedeutet nichts weiter als: Das muss richtig gut sein, und zwar nach dem Urteil eines anderen, nicht nach dem eigenen. Ein stärkeres Modell findet vielleicht noch ein, zwei Dinge, aber irgendwann ist Code einfach gut. Letztlich geht es darum, den ganzen Entwickler-Workflow aus Tests schreiben, Code schreiben und Refaktorisieren in den KI-Workflow zu holen. Vom Schraubenzieher zum Akkuschrauber: Halten muss man ihn immer noch selbst.
Das Prinzip lässt sich übertragen
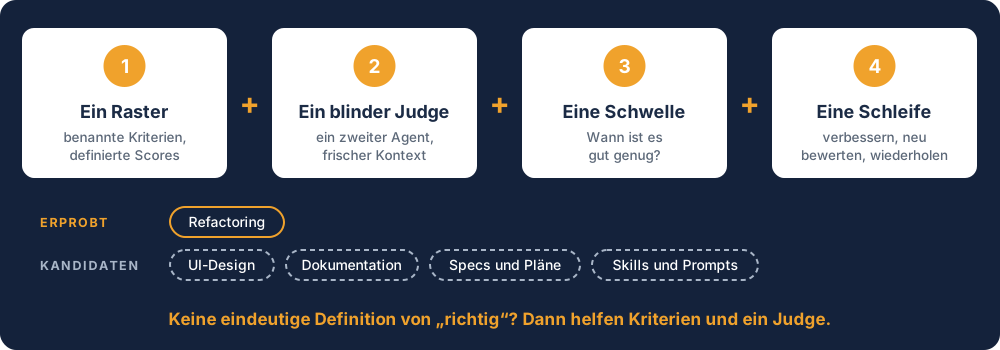
Refactoring ist nur das Beispiel. Alles, was sich beschreiben, aber nicht testen lässt, kann auf dieselbe Weise schrittweise besser werden. Keine eindeutige Definition von „richtig“? Dann bekommt die Aufgabe Kriterien und einen Judge. Vier Zutaten genügen: ein Bewertungsraster mit benannten Kriterien und definierten Punkten, ein blinder Judge in Form eines zweiten Agenten mit frischem Kontext, ein Schwellwert, der festlegt, wann es gut genug ist, und eine Schleife aus Verbessern, Neubewerten und Wiederholen.
Vier Zutaten machen aus einer weichen Qualität ein Ziel, auf das ein Agent hinarbeiten kann: ein Bewertungsraster mit definierten Punkten, ein blinder Judge in frischem Kontext, ein Schwellwert und eine Schleife, die so lange läuft, bis er erreicht ist.
Neben dem Refactoring bietet sich zum Beispiel UI-Design an: Ein LLM schaut sich die Oberfläche an und bewertet Typografie, Kontrast und Layout, und ein Agent passt das Design an, bis alle Kriterien erfüllt sind. Ebenso naheliegend sind Dokumentation, Spezifikationen und Pläne sowie Skills und Prompts selbst. Gerade Pläne und Dokumente aus der Feder eines LLM werden gerne sehr lang, und am Ende liest sie niemand. Auch dafür lassen sich Kriterien formulieren. Steht das Wichtigste ganz oben, sodass der Anfang für das grobe Bild genügt? Enthält das Dokument nur, was hineingehört, oder steht im Architekturdokument plötzlich die Timeline der Entstehung?
Für den Einstieg braucht es wenig. Nehmen Sie eine Qualität, über die in Ihren Reviews immer wieder diskutiert wird, und schreiben Sie eine Handvoll Kriterien dafür auf. Leiten Sie die Punkte aus dem Schweregrad gefundener Probleme ab statt aus dem Bauchgefühl. Lassen Sie in jeder Runde einen frischen Agenten mit einer festen Prompt-Vorlage bewerten, die das Ziel nicht verrät, setzen Sie die Schwelle bei 9, beginnen Sie mit einem einzigen Commit und sehen Sie sich die ersten Läufe genau an. Dort zeigt sich, was Ihr Raster tatsächlich belohnt.
Agenten erzeugen heute in kurzer Zeit sehr viel Code. Ob dieser Code in einem Jahr noch wartbar ist, entscheidet sich an den Qualitäts-Gates, die man um sie herum baut. Genau daran arbeiten wir bei itemis im Rahmen von AI Enablement: Wir bauen Prüfschleifen wie diese in agentische Workflows ein, damit Tempo nicht auf Kosten der Wartbarkeit geht. Wenn Ihr Team bereits viel Code von Agenten schreiben lässt und sich fragt, wie die Qualität dabei mithält, sprechen Sie uns an.
itemis · AI Enablement — Wir unterstützen Teams dabei, KI in der Softwareentwicklung produktiv einzusetzen: passende Werkzeuge und Modelle auswählen, sie in bestehende Systeme und Qualitäts-Gates integrieren und agentische Workflows aufbauen, die Ihre Leute selbst besitzen und weiterentwickeln. Mehr über AI Enablement →
Mit über 20 Jahren Erfahrung in der Softwareentwicklung, davon 9 bei itemis als Principal Engineer, hat Arne Deutsch tiefes technisches Wissen in diversen Projekten gesammelt – insbesondere im Java-Umfeld, in der Toolentwicklung und der Migration von Altprojekten. Er hat als Committer sowohl an Xtext als auch an Operaton mitgewirkt, Team-Projekte geleitet und beim Kunden vor Ort gearbeitet. Seit zwei Jahren konzentriert er sich auf agentisch unterstützte Softwareentwicklungsprozesse.
Wie man den Großteil der Softwareentwicklung an KI-Agenten übergibt – und trotzdem ein Ergebnis bekommt, dem man vertrauen kann. Ein Praxisblick auf vertikale Agenten und horizontale Skills für Enterprise-Teams.


 Arne Deutsch
 Arne Deutsch
8 Min. Lesezeit