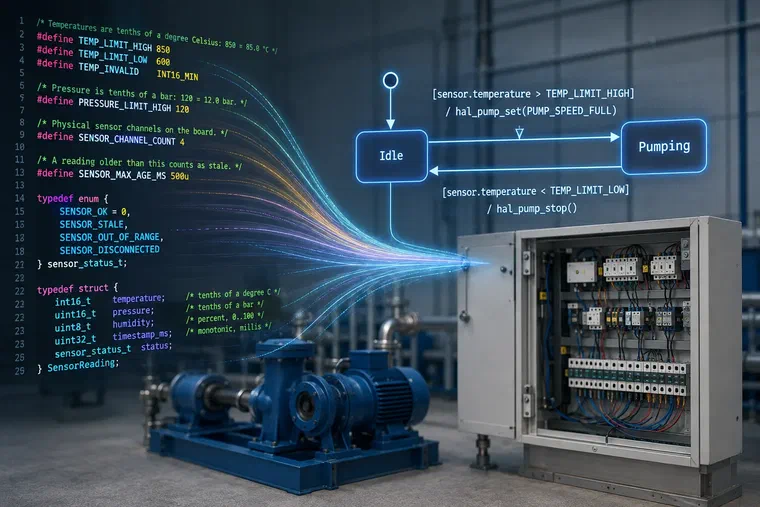
In einem itemis-CREATE-Statechart kann eine Transitionsbedingung und -aktion so aussehen:
[sensor.temperature > TEMP_LIMIT_HIGH] / hal_pump_set(PUMP_SPEED_FULL)
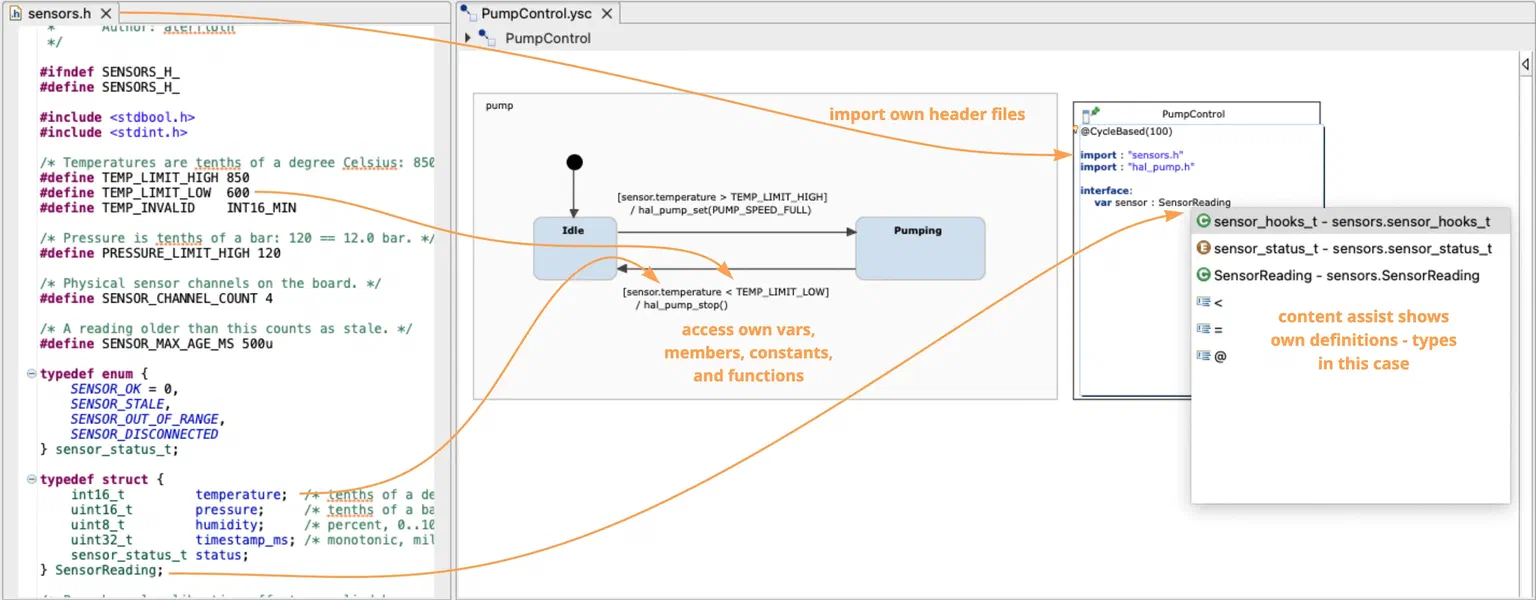
Auf den ersten Blick unauffällig. Interessant wird die Zeile bei der Frage, woher die vier Bezeichner kommen. Aus sensors.h stammen der typedef struct SensorReading, mit dem sensor deklariert ist, und die Grenzwert-Konstante TEMP_LIMIT_HIGH. Aus hal_pump.h kommen die Treiberfunktion hal_pump_set() und die Drehzahlkonstante PUMP_SPEED_FULL.
Alle vier stammen aus Code, der seit Jahren im Projekt liegt. Sie wurden nicht ins Modell übertragen, nicht als Modelltypen nachgebaut und nicht über ein Interface durchgereicht. Der Statechart-Editor hat die Header gelesen, bietet Content-Assist darauf an und prüft den Feldzugriff sensor.temperature gegen die echte Struct-Definition.
Bemerkenswert an diesem Ausdruck ist also weniger, was dasteht, als was fehlt: die Schicht dazwischen. Und genau diese Schicht ist der Grund, warum Modellierung in bestehenden Projekten so oft im Sand verläuft.
Das Diagramm an der Wand und der Code, der gilt
Seit 2006 begleite ich bei itemis Teams, die modellbasierte Methoden anwenden oder einführen wollen. Der Ausgangspunkt ähnelt sich oft stark.
Das zu entwickelnde System ist im Grunde reaktiv: Es reagiert auf Sensoren, Taster, Timer oder Busnachrichten, hält dabei Zustände und löst unter definierten Bedingungen Aktionen aus. Dies ist sehr häufig bei eingebetteten Systemen der Fall, aber auch in vielen anderen ereignisgetriebenen Anwendungssystemen. Diese Logik als reinen Code zu lesen, ist mühsam, weil über Flags, switch-Blöcke und Bedingungen verteilt steht, welche Zustände es gibt und wann welcher Übergang feuert.
Also wird gezeichnet. Ein Zustandsautomat auf dem Whiteboard, in der Spezifikation, im Architekturdokument. Das funktioniert gut. Das Bild klärt Reviews, bringt neue Teammitglieder schneller hinein und macht Diskussionen mit Fachbereich und Test überhaupt erst möglich. Zustandsautomaten sind an dieser Stelle kein Entwicklungswerkzeug, sondern ein Verständigungsmittel, und darin sind sie stark.
Dann wird das Diagramm von Hand implementiert, als Enum mit switch, als Zustandstabelle oder als State-Pattern. Diese drei Varianten haben wir in einer eigenen Serie durchgespielt. Sie funktionieren alle, und sie haben alle denselben Haken.
Ab diesem Moment existieren zwei Artefakte: das Bild, das erklärt, und der Code, der gilt. Beide beschreiben dasselbe Verhalten, aber nur eines wird ausgeführt. Jede Änderung müsste beide treffen; unter Termindruck trifft sie den Code, denn der Code muss laufen. Das Diagramm zieht man nach, wenn Zeit ist.
Nach ein paar Iterationen zieht es niemand mehr nach. Es stimmt noch ungefähr, und bei einem Zustandsautomaten ist „ungefähr“ gleichbedeutend mit falsch: Ein fehlender Guard oder ein vergessener Übergang aus dem Fehlerzustand sitzt genau dort, wo auch die interessanten Fehler sitzen. Das Diagramm erklärt dann ein System, das es so nicht mehr gibt. Als Verständigungsmittel ist es damit schädlich geworden und nicht bloß wertlos.
Warum der naheliegende Ausweg einen zweiten Bruch erzeugt
Wenn das Diagramm ohnehin die Wahrheit beschreiben soll, dann ist der naheliegende Schluss, aus diesem auch direkt Code zu erzeugen. Das Diagramm ist das eine führende Artefakt und es gibt keine Synchronisationsfrage mehr.
Der Schluss stimmt. In den Einführungen, die ich begleitet habe, klemmt es aber regelmäßig an dieser Stelle. Das Modellwerkzeug bringt seine eigene Welt mit, mit einem Typsystem, das die Typen des Projekts nicht kennt, ohne Kenntnis der Treiber-API, der Konstanten, der Fehlercodes. Was das Modell braucht, muss also im Modell noch einmal definiert werden; was es aufrufen soll, wird über eine Schnittstelle nach außen gereicht und auf der anderen Seite angebunden.
Dieser Anbindungscode ist der eigentliche Preis. Er ist langweilig, er ist umfangreich, und er ist die zweite Stelle, an der dieselbe Information steht. Ändert sich ein Struct-Feld oder eine Konstante, muss die Modellseite nachgezogen werden. Das Team hat jetzt zwei Brüche statt einem, und der neue wiegt schwerer, weil er die Doku unberührt lässt und stattdessen den Build betrifft.
Daran scheitern Modellierungseinführungen: nicht an der Notation und nicht am Werkzeug, sondern an der Erkenntnis nach drei Wochen, dass gerade eine Parallelwelt entsteht, die ab jetzt gepflegt werden will.
Das Modell als Erweiterung des Codes
Der zweite Bruch lässt sich vermeiden, wenn das Modell die Sprache des Projekts spricht.
Gemeint ist damit mehr als die Zielsprache der Generierung. Die Ausdruckssprache im Modell verwendet dasselbe Typsystem wie der vorhandene Code: dieselben Typen, dieselben Konstanten, dieselben Signaturen. Das Modell importiert die vorhandenen Header oder Klassen und arbeitet direkt darauf.
Die Rollenverteilung verschiebt sich damit gegenüber der reinen Lehre der modellgetriebenen Softwareentwicklung. Das Modell tritt nicht an, den Code zu ersetzen; es erweitert ihn und ist für genau den Teil zuständig, der als Code schlecht lesbar ist.
Daraus folgt der praktische Nutzen. Wenn das Modell einen Ausschnitt übernimmt und den Rest unangetastet lässt, wird seine Einführung zu einer lokalen Entscheidung: ein Statechart für eine Komponente, im bestehenden Projekt, in der bestehenden Toolchain. Und weil aus diesem Statechart der Code entsteht, der tatsächlich läuft, verschwindet auch der erste Bruch. Das Diagramm erklärt die Implementierung nicht mehr, es ist sie.
„Wir müssten unsere Definitionen im Modell neu aufbauen“
Der häufigste Einwand, und er trifft zu, solange das Werkzeug kein Konzept dafür hat.
In itemis CREATE übernimmt das ein Import. Im C/C++-Fall genügt im Statechart:
import: "sensors.h"
import: "hal_pump.h"
Damit stehen im Modell zur Verfügung: Funktionen (auch mit variadischen Parametern), Typedefs, Structs, Unions und Enums, Funktionszeiger innerhalb von Structs, #define-Makrowerte, Variablen, statisch allozierte Arrays sowie Pointer. In C++ kommen Smart-Pointer, Klassen mit ihren Feldern und Methoden hinzu, Namespaces (die im Statechart als Packages erscheinen), Template-Klassen und -Funktionen sowie Funktionen mit optionalen Parametern.
Variablen lassen sich dabei als Wert oder als Zeiger deklarieren, var n: int32_t neben var pInt: pointer<int32_t>, und für C++ Smart Pointer var spInt: shared_ptr<int32_t>, den der Generator auf Wunsch wieder zu einem Rohzeiger auflöst. Dereferenziert wird über die Extension-Funktion value, die auf jeder Zeiger-Variablen verfügbar ist; bei mehrfacher Indirektion staffelt sie sich entsprechend, etwa n = ppInt.value.value.
Für Java gilt dasselbe Prinzip mit Java-Mitteln. Importiert werden Klassen, Interfaces und Enums; auf einer Variablen eines Java-Typs sind alle öffentlichen Member zugänglich, Methoden wie Felder, statische eingeschlossen. Innere Klassen und Enumeratoren lassen sich verwenden, und Konstruktoren erscheinen als statische new(...)-Methoden, sodass Objekte direkt im Modell entstehen. Zur Verfügung steht dabei alles, was im Classpath des Projekts liegt, die Standardtypen und -klassen von Java eingeschlossen; Content Assist listet sie beim Import auf. Die Transition von oben liest sich dann so:
[reading.getTemperature() > Limits.TEMP_HIGH] / pump.setSpeed(PumpSpeed.FULL)
Der Editor ist gegenüber diesen Bezeichnern nicht bloß tolerant, er kennt sie: Content-Assist listet die zugänglichen Member auf, die Validierung prüft Feldzugriffe und Aufrufe gegen die tatsächliche Deklaration. Ein Tippfehler im Feldnamen fällt im Editor auf und nicht im Build.
„Das Modell kennt unsere Hardware und unsere APIs nicht“
Dass es sie kennen kann, liegt am Domänenkonzept von itemis CREATE. Beim Anlegen eines Statecharts wird eine Domain gewählt, im Wizard oder später in den Statechart-Properties. Zur Verfügung stehen die Default-Domain für Modelle ohne Sprachanbindung, eine C-, eine C++- und eine Java-Domain sowie eine SCXML-Domain. Die Domain legt fest, welches Typsystem die Ausdruckssprache im Modell verwendet.
Für eingebettete Entwicklung ist das mehr als Bequemlichkeit. Die C-Domain kennt int8_t bis int64_t, uint8_t bis uint64_t, dazu bool, float, double, string und void: also die Breiten, in denen auf der Zielhardware tatsächlich gerechnet wird, statt einer generischen Zahlendarstellung, die der Generator später irgendwie abbilden muss.
Voraussetzungen auf der C/C++-Seite: ein CDT-Projekt, ein Statechart in der C- oder C++-Domain sowie Header im Workspace oder in den CDT-Include-Pfaden. Erkannt werden .h, .hh, .hpp, .hxx und .inc. Die Details stehen in der Dokumentation zur Deep-C/C++-Integration.
„Der generierte Code passt nicht zu unserem Code“
Hier zahlt sich der Import ein zweites Mal aus. Weil die Ausdrücke im Modell bereits auf den echten Deklarationen beruhen, ruft der generierte Zustandsautomat die vorhandenen Funktionen direkt auf und verwendet deren Datentypen unverändert. Eine Adapterschicht, die erzeugt, gepflegt und verstanden werden müsste, gibt es nicht. Der Glue-Code entfällt nicht durch Disziplin, sondern weil nichts zu verkleben ist.
Der bestehende Build behandelt den generierten Code wie jeden anderen: derselbe Compiler, dieselben Flags, dieselben statischen Analysen. Ob dabei alle per Deep-Integration eingebundenen Header im generierten Header landen oder nur die tatsächlich verwendeten, regelt ein Konfigurationsparameter. Der Generierungsschritt lässt sich in den automatischen Build einhängen, sodass bei jedem Lauf reproduzierbar dasselbe Ergebnis aus dem Modell entsteht.
Wann man das Modell besser nicht an die Sprache bindet
Die tiefe Integration ist ein Tausch. Sie nimmt den Anbindungscode weg und bezahlt mit Bindung: Das Modell kennt von da an eine konkrete Sprache und eine konkrete Codebasis. In vier Situationen ist dieser Tausch schlecht, und dann ist die Default-Domain mit deklarierten Operationen die bessere Wahl.
Nicht jedes Verhalten braucht mehr, als der Statechart selbst mitbringt. Kommt die Logik mit bool, Ganzzahlen und einer Handvoll Ereignisse aus und wird die Außenwelt über deklarierte Operationen erreicht, bringt ein Import nichts ein, weil es nichts zu importieren gibt, das der Sprachkern nicht schon abdeckt. Manche Teams behalten die Indirektion auch dann, wenn sie sie auflösen könnten: Die deklarierte Operation ist die Stelle, an der sich eine Implementierung austauschen lässt, gegen ein Test-Double, gegen eine andere HAL, gegen einen Simulator.
Soll aus demselben Statechart Code für mehrere Zielsprachen entstehen, schließt die tiefe Integration das aus. itemis CREATE generiert C, C++, C#, Java und Python; tiefe Domains gibt es für C, C++ und Java. Ein Statechart in der C-Domain lässt sich deshalb nicht sinnvoll für Python-Code verwenden, denn für Python existiert keine Domain, in der die importierten Deklarationen eine Entsprechung hätten. Zeitlich versetzt gilt dasselbe, wenn eine Codebasis später auf eine andere Sprache migriert werden soll.
Der dritte Fall betrifft Projekte, die konsequent modellieren. Stammen die Datentypen und Schnittstellen, die der Statechart verwendet, selbst aus Modellen statt aus C-, C++- oder Java-Quellen, findet die Sprachintegration nichts, woran sie andocken könnte. Das Modell soll dann mit anderen Modellen zusammenpassen, nicht mit Code.
Und schließlich der Fall, in dem es noch gar keinen Code gibt. Wer das Verhalten modelliert, bevor Treiber oder Zulieferer-Schnittstelle existieren, hat keinen Header zum Importieren. Deklarierte Operationen sind hier kein Kompromiss, sondern die einzig mögliche Reihenfolge: Der Statechart ist die Spezifikation, an der sich die Implementierung später ausrichtet.
Welche Sprachkonstrukte die Integration im Einzelnen abdeckt und wo sie heute Lücken hat, steht in der Dokumentation. Für die Entscheidung, ob man sie überhaupt einsetzt, sind die vier Fälle der bessere Maßstab.
Ein Prinzip, kein Feature
Deep C/C++ Integration und Deep Java Integration sehen aus wie zwei Funktionen desselben Werkzeugs. Es sind zwei Instanzen derselben Idee: Ein Modell muss keine geschlossene Welt sein, es kann sich an die Sprache anpassen, in der das Projekt ohnehin denkt. Damit wird es aus einer Alternative zum Code zu einer Erweiterung davon.
Das Prinzip trägt über Zustandsautomaten hinaus. Eine domänenspezifische Sprache nützt genau dann, wenn sie an die vorhandenen Begriffe und Artefakte andockt, statt daneben eine zweite Beschreibung des Systems aufzubauen. Wie man solche Sprachen entwirft, ist Thema des Bereichs Custom Tools.
Für den Anfang genügt die kleine Variante, und sie ist der eigentliche Punkt: ein Statechart, für eine Komponente, im bestehenden Projekt. Die Header sind schon da. Die Skizze auch; sie hängt an der Wand und stimmt seit dem letzten Sprint nicht mehr.
Einen Überblick über Editor, Simulation und Generatoren gibt die itemis CREATE Produktseite.
Modellgetriebene Softwareentwicklung bei itemis: Zustandsautomaten modellieren, simulieren und daraus Code generieren: Modellgetriebene Softwareentwicklung →


 Axel Terfloth

 Axel Terfloth
7 Min. Lesezeit

