


So einfach wie Visio, nur korrekt: SysML v2 mit dem KISS-Prinzip
 Andreas Mülder
11 Min. Lesezeit
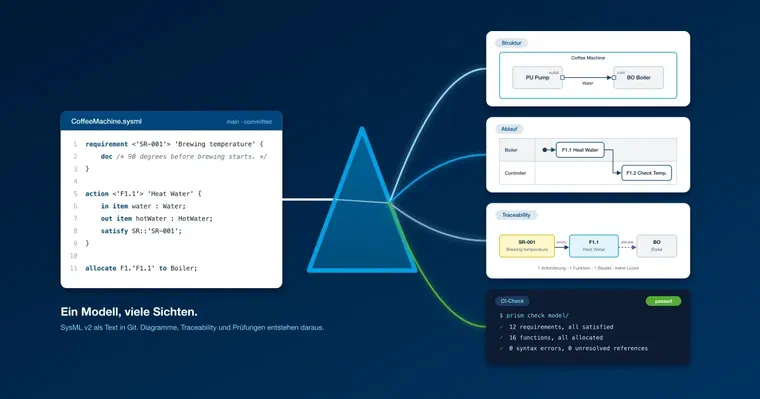
Jedes Projekt hat sie: die Architekturzeichnung in Visio, die nach sechs Monaten niemand mehr pflegt. Formale Modelle lösen das Problem, und mit SysML v2 gibt es dafür einen offenen Standard mit Textnotation. Nur ist die Sprache groß, und viele Teams scheitern an der Syntax, bevor der Nutzen anfängt. Der Ausweg ist ein Prinzip, das in der Softwareentwicklung längst etabliert ist: KISS, „Keep it simple, stupid", also Dinge so einfach wie möglich halten. Übertragen auf SysML v2 heißt das: ein Subset, das das Projekt selbst festlegt und das jeder im Team lesen kann, plus ein Werkzeug, das die Syntax schreibt. So einfach wie Visio, nur eben korrekt.
Das Diagramm, das niemand mehr pflegt
Jedes Projekt hat es: das Architekturbild aus Visio, Folie 3 im Kick-off. Sechs Monate später hat das System drei neue Komponenten, der Sensor heißt anders und die Schnittstelle zum Zulieferer läuft über einen anderen Bus. Die Folie zeigt noch den Stand vom Kick-off.
Visio ist daran unschuldig. Es ist schnell, jeder kann es bedienen, die Bilder sehen gut aus. Nur weiß das Bild nichts. Ein Kasten „Controller" ist für Visio ein Rechteck mit Text. Ob es den Controller noch gibt, ob er die Anforderung SR-012 erfüllt, ob die Linie zum Sensor Daten oder Strom führt, weiß nur der Mensch, der das Bild gezeichnet hat.
Abgleichen lässt sich so ein Bild nur von Hand, und das hört nach dem dritten Diagramm auf. Übrig bleibt Dekoration mit Verfallsdatum. Warum das kein MBSE ist, hat mein Kollege Alexander Nyssen in seinem Beitrag Kein MBSE mit draw.io oder Visio begründet.
Was ein formales Modell anders macht
Ein formales Modell beschreibt dasselbe System, aber in einer Sprache mit festen Regeln. Der Kasten „Controller" ist kein Rechteck mehr, sondern ein Bauteil mit Namen und Typ. Ein Port hat eine Richtung, eine Anforderung wird von benannten Elementen erfüllt. Ein Werkzeug kann das Modell auswerten. Damit stehen der Systemarchitektur dieselben Praktiken offen, die sich in der Softwareentwicklung seit langer Zeit bewährt haben:
- Architecture as Code. Das Modell liegt im Textformat in einem Repository, zum Beispiel Git. Dadurch lässt es sich behandeln wie jeder andere Quelltext: Branches, Diffs, Merge Requests, Blame. Wer wann warum die Schnittstelle geändert hat, steht im Log und nicht in einer E-Mail.
- Pipelines. Bei jedem Push prüft die CI das Modell: Syntaxfehler, kaputte Verweise, Anforderungen ohne Realisierung, Funktionen ohne Bauteil. Rot oder grün, bevor ein Mensch draufschaut.
- Validatoren. Regeln, die das Team selbst festlegt. „Jede Systemfunktion ist allokiert." „Jeder Port ist typisiert." Einmal geschrieben, bei jeder Änderung geprüft.
- Requirements Traceability. Jede Anforderung trägt im Modell, woraus sie abgeleitet ist, welche Funktion sie erfüllt und auf welchem Bauteil diese läuft. Die Traceability-Matrix für das Audit ist damit eine Abfrage über das Modell und entsteht in Sekunden. Eine Anforderung ohne Realisierung fällt beim Push auf, lange vor dem Review.
- Diagramme als Ausgabe. Strukturdiagramm, Funktionsablauf mit Swimlanes, Anforderungslandschaft entstehen aus dem Modell. Niemand zeichnet sie nach, niemand vergisst sie zu aktualisieren.
- Lesen ohne Werkzeuglizenz. Was aus dem Modell erzeugt wird, lässt sich als Website oder als eine einzige HTML-Datei weitergeben. Projektleitung, Fachabteilung und Prüfer lesen im Browser, der Zulieferer bekommt die Datei per Mail, und niemand braucht dafür ein Modellierungswerkzeug.
- KI-Werkzeuge ohne Umweg. Weil das Modell Text ist, arbeiten KI-Assistenten direkt damit: Sie lesen das Modell, schlagen Anforderungen oder Bauteile vor, erklären Zusammenhänge und schreiben gültige Syntax. SysML v2 ist ein etablierter Standard, und aktuelle Sprachmodelle beherrschen die Notation. Es braucht keine Schnittstelle zu einem Werkzeugformat, nur die Datei.
- Integrationstests gegen das Modell. Die Schnittstellentabelle, gegen die der Zulieferer testet, ist dieselbe, aus der die Architektur gezeichnet wird. Signalnamen und Typen kommen aus einer Quelle.
Dafür reicht ein Modell, das eine Maschine eindeutig lesen kann, und ein paar Skripte, die daraus etwas machen. Ein großes MBSE-Werkzeug ist dabei optional. Das ist der eigentliche Gewinn: Das Modell wird vom Dokument zur Datenquelle.
Warum SysML v2 und nicht das Format von Werkzeug X
Formale Modelle gab es schon vor SysML v2. Sie lagen nur im Datenformat eines Werkzeugs: ein Binärformat oder ein XML, das nur dieses Werkzeug schreibt und liest. Das Modell war damit an den Hersteller gebunden. Ein Werkzeugwechsel bedeutete eine Migration, bei der alles verloren ging, was das Zielformat nicht abbilden konnte.
SysML v2 ist ein offener OMG-Standard mit einer textuellen Notation. Drei Eigenschaften machen den Unterschied:
- Es ist Text. Eine
.sysml-Datei ist UTF-8. Git kann sie diffen, grep kann sie durchsuchen, ein Skript kann sie erzeugen oder auswerten. Ein Merge Request zeigt genau die drei Zeilen, die sich geändert haben. - Es ist offen. Grammatik und Referenzimplementierung sind veröffentlicht: Die OMG stellt ihre Pilot Implementation samt Parser als Open Source auf GitHub bereit (systems-modeling/sysml-v2-release). Wer die Sprache lesen will, braucht keine Lizenz. Und wer eine eigene Toolchain für Architecture as Code bauen will, setzt auf einem fertigen Parser auf: Ein Skript, das das Modell einliest und die Traceability-Tabelle baut oder eine Projektregel prüft, ist damit ein kleines Vorhaben.
- Ein Modell, viele Werkzeuge. Weil die Sprache standardisiert ist, kann ein Werkzeug das Modell schreiben, ein anderes es prüfen, ein drittes Diagramme daraus erzeugen. Ein Wechsel ist kein Migrationsprojekt, weil die Datei dieselbe bleibt.
So sieht das aus. Eine Anforderung, eine Funktion, die sie erfüllt, und das Bauteil, auf dem sie läuft:
requirement <'SR-001'> 'Brewing temperature' {
    doc /* The water shall reach 90 degrees before brewing starts. */
}

action <'F1.1'> 'Heat Water' {
    in item water : Water;
    out item hotWater : HotWater;
    satisfy SR::'SR-001';
}

allocate F1.'F1.1' to Boiler;
Das liest sich wie Code, und genau das ist der Punkt. Ein Mensch kann es im Review lesen. Ein Skript kann daraus die Traceability-Tabelle bauen: SR-001 wird von F1.1 erfüllt, F1.1 läuft auf dem Boiler. Fehlt eine der drei Zeilen, meldet die CI eine Anforderung ohne Realisierung. Ob sich der Umstieg von SysML v1 lohnt, hat Benjamin Alders nüchtern durchgerechnet.
Der Haken: SysML v2 ist eine große Sprache
Und hier verlieren wir die meisten Systems Engineers. SysML v2 soll alles ausdrücken können, was ein Systemmodell braucht: Struktur, Verhalten, Anforderungen, Zustandsautomaten, Berechnungen, Constraints, Use Cases, Verifikationsfälle, Varianten, Ausdrücke mit Einheiten, dazu KerML als Kernsprache darunter und eine Standardbibliothek mit Größen und SI-Einheiten. Die aus der Spezifikation erzeugte Grammatik hat rund 2.200 Zeilen.
Für die Sprache ist das richtig so. Für ein Team, das ein Strukturdiagramm mit acht Blöcken und eine Funktionskette braucht, steht der Lernaufwand in keinem Verhältnis zum Nutzen. Was im Alltag passiert:
- Syntaxfehler. Ein fehlendes Semikolon,
:>>statt:>, ein Hochkomma zu wenig um einen Namen mit Leerzeichen. Der Parser meldet Zeile 212, der Ingenieur sucht. - Verweise.
CoffeeRequirements::SR::'SR-T1'::'SR-001'muss exakt so heißen. Umbenennen heißt: alle Stellen finden, in allen Dateien. - Wahlmöglichkeiten. Soll die Funktion ein
action defoder eineactionsein?partoderitem?connect,interfaceoderflow? Die Sprache lässt alles zu. Das Projekt muss entscheiden, und jeder im Team muss die Entscheidung kennen und einhalten. - Eigene Begriffe. Was eine „Systemfunktion" oder eine „Einheit" ist, kennt SysML v2 nicht. Das Projekt definiert
@SystemFunctionselbst, und alle müssen es gleich schreiben, sonst findet das Skript die Hälfte nicht.
Das Ergebnis kennt jeder, der es probiert hat: Das Modell wird zur Aufgabe für die zwei Leute im Team, die die Sprache können. Der Rest wartet auf sie oder zeichnet wieder in Visio. Ein Modell, das nur zwei Leute lesen können, wird nicht gelesen. Damit ist der Vorteil des formalen Modells weg, bevor er angefangen hat.
KISS, angewendet auf SysML v2
Der Maßstab für „einfach" ist der Ingenieur im Team, der kein Sprachexperte ist: Was er nicht lesen kann, pflegt er nicht. Der Ausweg ist derselbe wie bei jeder großen Sprache: ein Subset. Ein Team braucht die zehn Konstrukte, mit denen sein Projekt arbeitet, und eine Vereinbarung, wie es sie benutzt. Der Rest der Sprache darf liegen bleiben.
Dasselbe System, zweimal modelliert
So sieht die Brewing-Temperature-Anforderung aus, wenn man alles nimmt, was SysML v2 anbietet. Einheiten aus der Standardbibliothek, ein auswertbarer Constraint, eine Interface-Definition mit zwei Enden, ein Zustandsautomat für den Boiler:
private import ISQ::*;
private import SI::*;

requirement def <'SR-001'> 'Brewing temperature' {
    subject boiler : Boiler;
    attribute minTemp : TemperatureValue = 90 ['°C_abs'];
    require constraint { boiler.waterTemp >= minTemp }
}

interface def WaterPipe {
    end supplierPort : ~WaterPort;
    end consumerPort : WaterPort;
    flow of Water from supplierPort.water to consumerPort.water;
}

part def Boiler {
    attribute waterTemp : TemperatureValue;
    port inlet : WaterPort;
    exhibit state boilerStates : BoilerStates;
}

part boiler : Boiler[1];
part pump : Pump[1];
interface pipe : WaterPipe connect pump.outlet to boiler.inlet;
Und so, wenn das Projekt nur das modelliert, was es im Alltag auswertet:
requirement <'SR-001'> 'Brewing temperature' {
    doc /* The water shall reach 90 degrees before brewing starts. */
    attribute :>> priority = "high";
}

part boiler : Boiler {
    port inlet : WaterPort;
}
part pump : Pump {
    port outlet : ~WaterPort;
}
flow of Water from pump.outlet to boiler.inlet;

action <'F1.1'> 'Heat Water' {
    satisfy SR::'SR-001';
}
Beide Varianten sind gültiges SysML v2. Die zweite ist halb so lang und kommt ohne Standardbibliothek, ohne Ausdrücke und ohne Zustandsautomat aus. Was sie weglässt, ist bewusst weggelassen:
- Den Constraint
waterTemp >= minTempwertet im Projekt kein Werkzeug aus. Die 90 Grad prüft der Prüfstand, nicht das Modell. Im Modell reicht der Satz indoc, den der Reviewer liest. - Die Einheit
['°C_abs']ist korrekt, aber ohne Auswertung reine Zeremonie. Sie bringt einen Import, eine Bibliothek und eine Fehlerquelle mit. - Die Interface-Definition mit zwei Enden sagt für das Diagramm dasselbe wie eine
flow-Zeile: Wasser fließt von der Pumpe zum Boiler. Die Schnittstellentabelle entsteht aus den Port-Typen. - Der Zustandsautomat hat in der Methodik des Projekts keinen Platz. Verhalten wird als Funktionskette mit Allokation beschrieben, und daraus entstehen die Swimlanes.
- Die Multiplizität
[1]ist der Standard. Sie steht da, weil man sie hinschreiben kann.
Diese Entscheidungen trifft das Projekt. Und genau das ist die Annahme hinter einem Subset: Es gibt einen Kern, den jeder im Team benutzt und den die Werkzeuge zeichnen und prüfen, und es gibt einen Aufsatz, der im Text erlaubt bleibt, aber nicht gebraucht wird. In unserem Fall sieht die Aufteilung so aus:
| Stufe | Konstrukte | Was damit passiert |
|---|---|---|
| Kern | package, part, port, item, attribute, action, requirement, connect, interface, flow, allocate, satisfy, derivation, view mit expose und render, Metadaten | Wird gezeichnet, geprüft, per Klick erzeugt und in der CI ausgewertet |
| Aufsatz, als Text erlaubt | state, transition, constraint, calc, use case, verification case, enumeration, Multiplizität, accept, send, if, while | Wird geparst und unverändert mitgeführt, erscheint im Modellbaum, hat kein Diagramm |
| Bewusst draußen | Standardbibliothek (ISQ, SI, Quantities), Auswertung von Constraints und Berechnungen, Simulation, Sequenzdiagramme | Wird nicht geladen und nicht ausgewertet; wer das braucht, nimmt ein vollständiges Werkzeug |
Ein anderes Projekt zieht die Linie anders. Wer Zustandsautomaten verifiziert, hat state im Kern. Wer Massebudgets rechnet, braucht Einheiten und Constraints. Das Subset ist eine Entscheidung pro Projekt, und sie gehört in eine Datei, die jeder lesen kann.
Drei Prinzipien
- Das Subset ist konfigurierbar, die Methodik auch. Das Projekt legt in einer Konfigurationsdatei fest, was seine Metadaten bedeuten:
@SystemFunctionist eine Funktion,@Uniteine Einheit,@Tapein Messabgriff. Die Methodik kommt aus dem Projekt, das Werkzeug liest sie nur. - Das Werkzeug schreibt die Syntax. Wer im Diagramm einen Port auf einen anderen zieht, bekommt
flow of Water from pump.outlet to boiler.inlet;ins Modell geschrieben. Wer eine Funktion in eine Swimlane schiebt, bekommt dieallocate-Zeile. Der Ingenieur klickt, die Syntax entsteht, inklusive Kurznamen-Nummerierung und Metadaten der Geschwister. Wer den Text lieber selbst tippt, darf das weiterhin. - Alles wird vor dem Schreiben geprüft. Egal ob eine Änderung aus dem Diagramm, aus dem Editor oder von einem KI-Assistenten kommt: Ergibt sie kein gültiges SysML v2, wird sie abgelehnt. Das Modell ist in jedem Zustand von jedem anderen SysML-v2-Werkzeug lesbar. Für den KI-Assistenten gilt dieselbe Regel, plus eine: Was er anlegt, trägt im Modell eine Proposed-Markierung und erscheint in jedem Diagramm gestrichelt, bis ein Mensch es freigibt. Auch das ist nur Standard-Metadatum im Text, kein Werkzeugzustand.
Das Ergebnis fühlt sich an wie Visio: Kästchen, Linien, Beschriftungen, Drag and Drop. Unter der Haube liegt Standardtext in Git, den ein Parser geprüft hat und den die CI bei jedem Push erneut prüft.
So sieht das mit PRISM aus
PRISM liest einen Ordner mit .sysml-Dateien aus Git und erzeugt daraus mit einem Befehl alle Sichten: Funktionsabläufe mit Swimlanes, die aus den Allokationen entstehen, Strukturdiagramme mit Ports und typisierten Verbindungen, Allokationen, Anforderungslandschaften und die Traceability jeder Anforderung bis zum Bauteil. Das Layout entsteht automatisch. Die Sichten öffnen im Browser, als statische Website oder als eine einzige HTML-Datei für den Zulieferer, ohne Lizenz für ein Modellierungswerkzeug.
Geändert wird, wo es gerade passt: im Diagramm (Port auf Port ziehen, Funktion in eine Swimlane schieben), im Detailpanel, im Texteditor mit Prüfung beim Tippen oder im Chat in normaler Sprache. Jede Änderung wird vor dem Schreiben geprüft, hat ein Undo und wird nur per Klick committet. Was der KI-Assistent anlegt, bleibt als Proposed markiert, bis ein Mensch es freigibt. Was das Projekt unter «Funktion» oder «Einheit» versteht, steht in einem Profil, und prism check läuft dieselben Regeln in der CI. PRISM läuft lokal auf dem Rechner; ohne Chat verlässt nichts das Gerät.
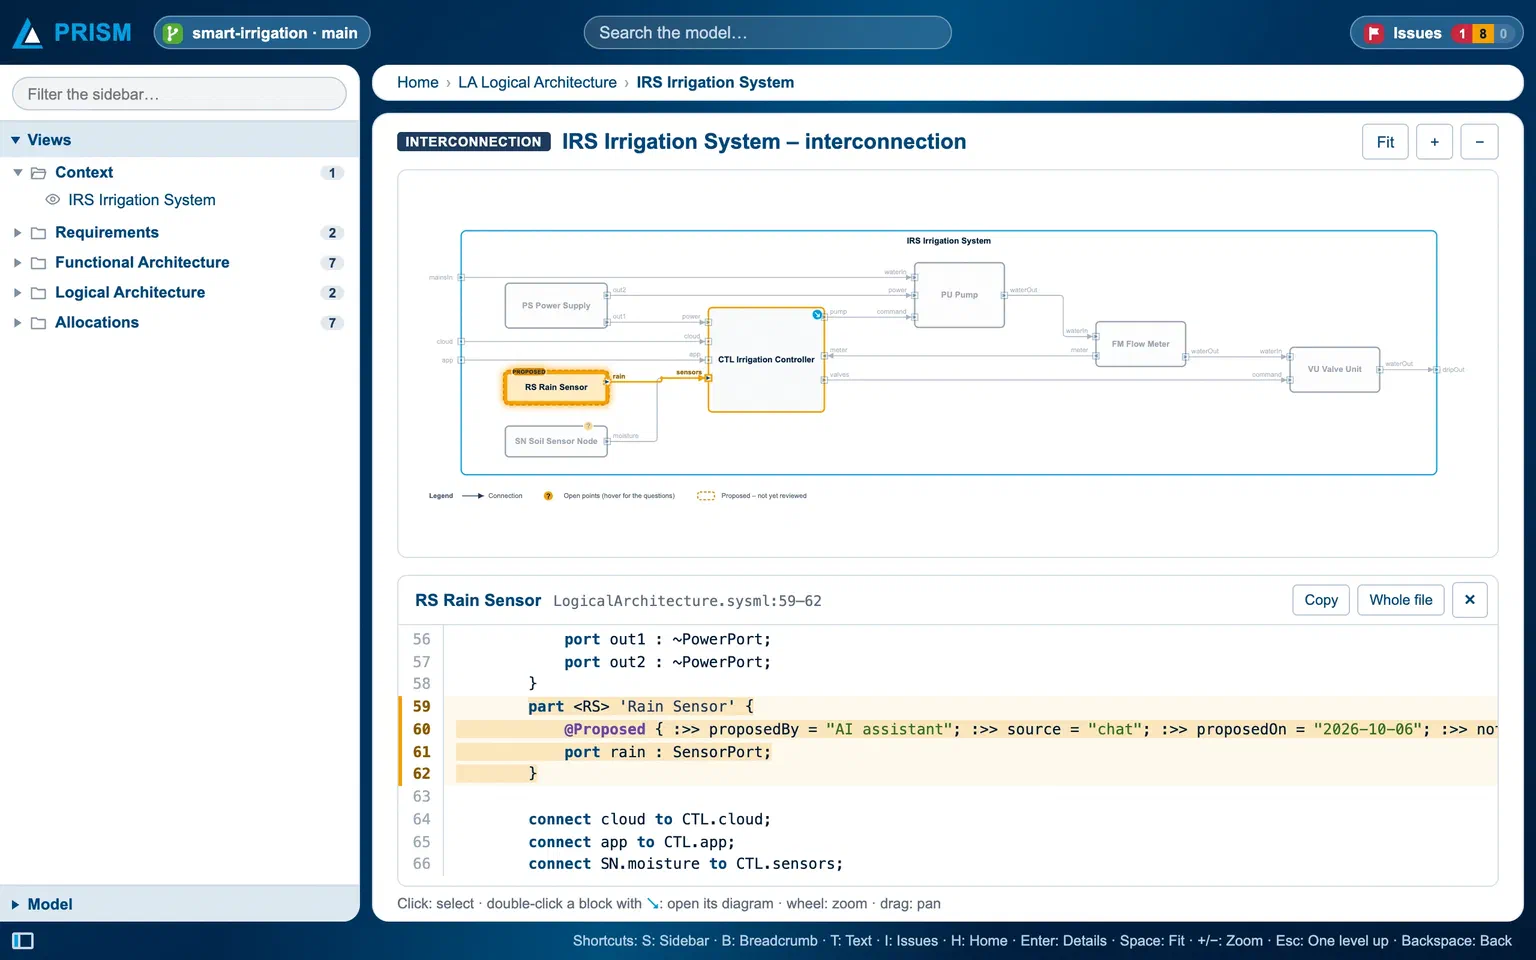
Strukturdiagramm und der SysML-Text dahinter in PRISM. Der von der KI vorgeschlagene Regensensor bleibt gestrichelt und trägt im Text die Proposed-Markierung, bis ein Mensch ihn freigibt.
PRISM ausprobieren mit Demo-Video, Beispielmodell und Demo-Termin: prism.itemis.com →
Principal Software Engineer